PDF in Text
Holen Sie den gesamten Text aus einem PDF, dank OCR auch aus gescannten Seiten.
- Kostenlos nutzbar
- Läuft auf jedem Gerät
- Bleibt auf Ihrem Gerät
- Eingebetteter Text exakt gelesen
- Gescannte Seiten werden erkannt
- Alle Seiten in einer Datei
- Kopieren oder herunterladen
Datei hierher ziehen
oder eine Datei von Ihrem Gerät auswählen
Wählen Sie ein PDF, um seinen Text zu extrahieren
Nur PDF-Dateien
Kein Internet? Windows-App holenAuf dem Handy? Handy-App holen
Wir ermitteln die Sprache anhand des Dokuments selbst.
Alles, was „PDF in Text“ kann
Holen Sie den Text jeder Seite aus einem PDF. Vorhandener Text wird exakt ausgelesen, und gescannte Seiten werden für Sie erkannt.
Was es liest
- Eingebetteter Text wird genau so übernommen, wie die Datei ihn speichert
- Gescannte Seiten werden automatisch erkannt, Seite für Seite
- Ein Dokument aus echtem Text und Scans wird durchgehend verarbeitet
- Zeilenumbrüche bleiben erhalten, sodass sich die Seite der Reihe nach liest
Dokumentsprache
- Die Sprache aus dem Dokument selbst ermitteln
- Bengalisch, Englisch, Hindi, Arabisch, Chinesisch, Russisch, Spanisch, Portugiesisch und Niederländisch
- Ihr Schriftsystem und Englisch werden zusammen gelesen, für Namen, Daten und Beträge
- Die Sprache selbst angeben und direkt zur Erkennung gehen
In der Arbeitsfläche
- Jede Seite auf dem Bildschirm mit eigener Miniaturansicht
- Zu jeder Seite springen und ihren Text neben der Seite lesen
- Eine Seite über die Schaltfläche auf dieser Seite kopieren
- Die Seiten klappen auf, sobald sie gelesen sind
Den Text mitnehmen
- „Alle Seiten kopieren“ mit einem Klick
- Das ganze Dokument als .txt-Datei herunterladen
- Jeder Block ist mit seiner Seitenzahl beschriftet
- Seitentext, den Sie direkt in ein Dokument einfügen können
So funktioniert es
PDF in Text in drei Schritten
Wählen Sie Ihr PDF
Ziehen Sie Ihre Datei auf das Feld oder klicken Sie darauf, um eine von Ihrem Gerät auszuwählen. Seiten ohne Textebene werden in Ihrem Browser gelesen, sobald die Datei geöffnet ist. Nur wenn Ihr Browser die Texterkennung nicht ausführen kann, werden diese Seiten als Bilder an unseren Server gesendet und gelöscht, sobald sie gelesen wurden.
Den Text Seite für Seite lesen
Jede Seite hat eine eigene Schaltfläche „Kopieren“. Kopieren Sie das ganze Dokument auf einmal oder laden Sie alles als .txt-Datei herunter, mit den Seiten in Reihenfolge.
Kopieren oder herunterladen
Erkannter Text ist eine Schätzung, keine Abschrift, prüfen Sie also alles, worauf Sie sich verlassen wollen, besonders Zahlen.
PDF in Text: Schritt für Schritt in Bildern
Eingebetteter Text wird direkt ausgelesen. Gescannte Seiten werden stattdessen erkannt, in neun Sprachen, die automatisch bestimmt werden.
Wählen Sie Ihr PDF
Ziehen Sie Ihre Datei auf das Feld oder klicken Sie darauf, um eine von Ihrem Gerät auszuwählen. Seiten ohne Textebene werden in Ihrem Browser gelesen, sobald die Datei geöffnet ist. Nur wenn Ihr Browser die Texterkennung nicht ausführen kann, werden diese Seiten als Bilder an unseren Server gesendet und gelöscht, sobald sie gelesen wurden.
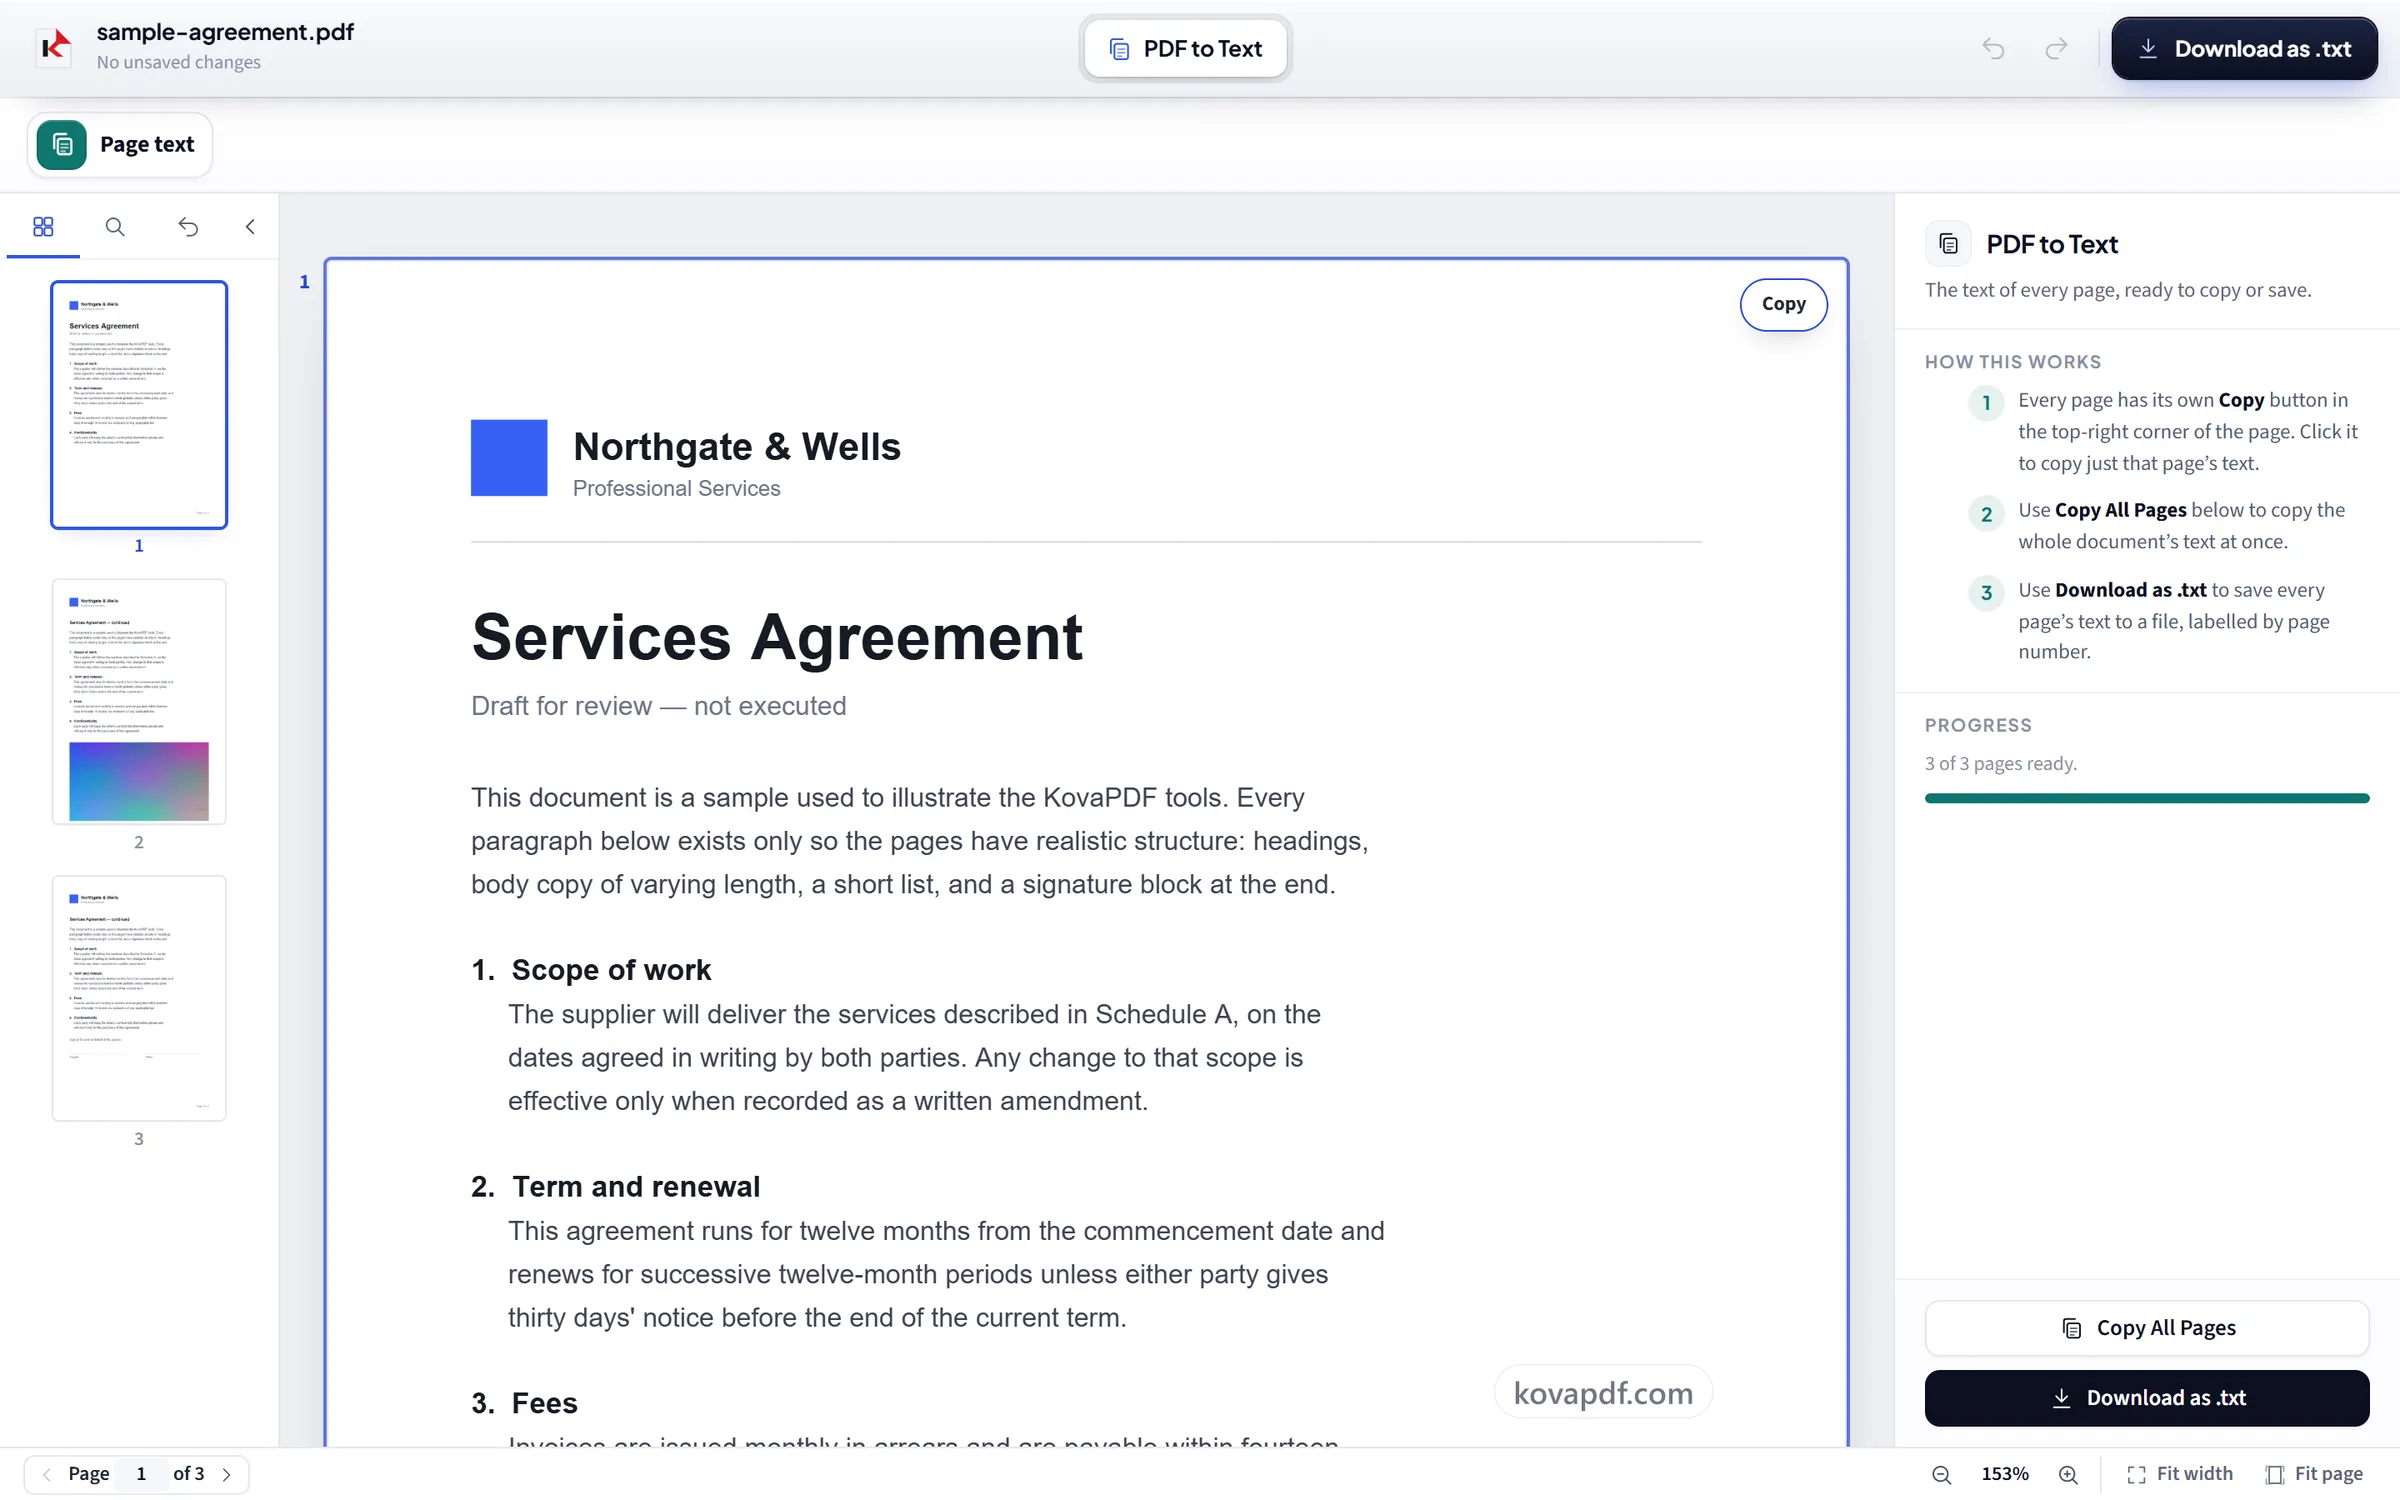
Den Text Seite für Seite lesen
Jede Seite hat eine eigene Schaltfläche „Kopieren“. Kopieren Sie das ganze Dokument auf einmal oder laden Sie alles als .txt-Datei herunter, mit den Seiten in Reihenfolge.
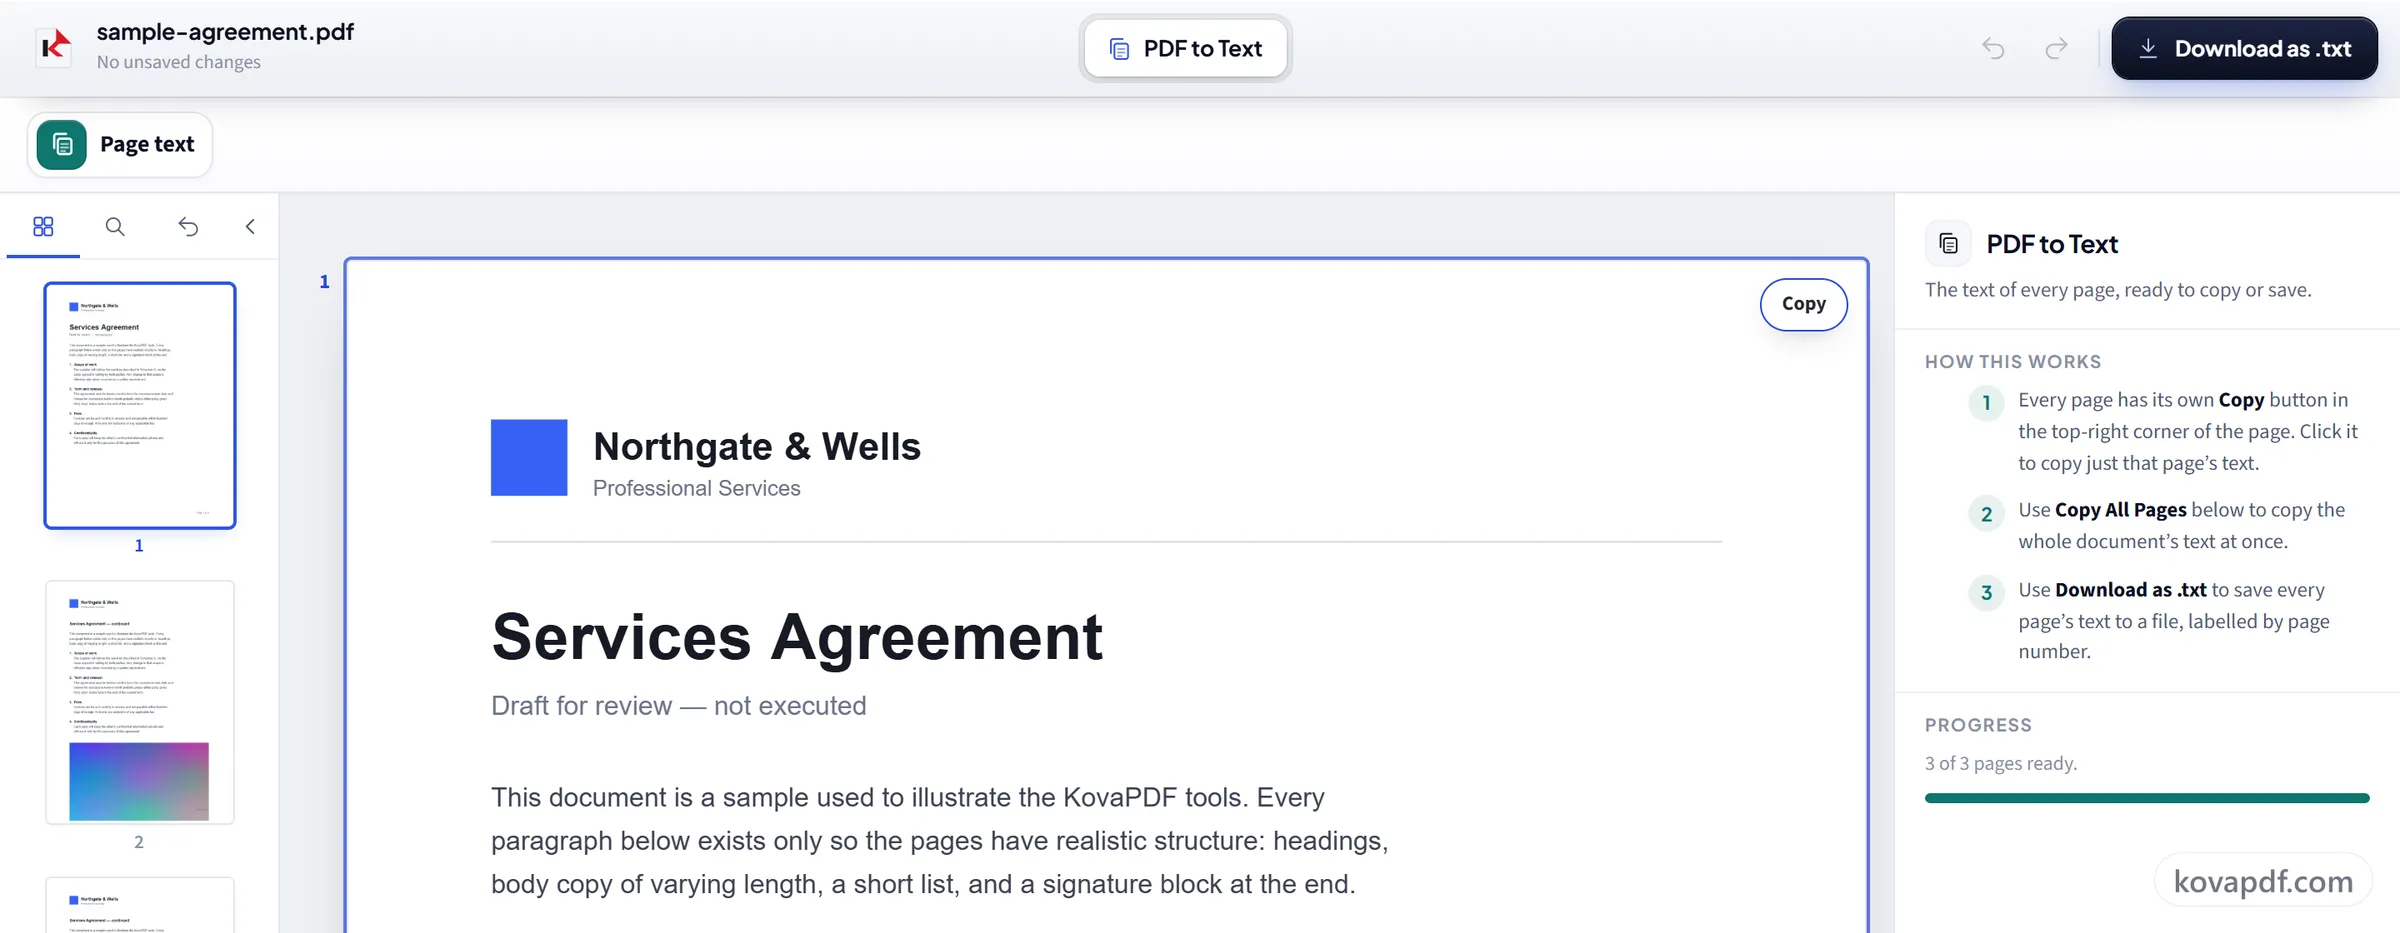
Kopieren oder herunterladen
Erkannter Text ist eine Schätzung, keine Abschrift, prüfen Sie also alles, worauf Sie sich verlassen wollen, besonders Zahlen.
Häufige Fragen zu PDF in Text
Wie kopiere ich Text aus einem PDF?
Öffnen Sie das PDF hier, und sein Text erscheint Seite für Seite. Kopieren Sie eine einzelne Seite, das ganze Dokument auf einmal oder laden Sie alles als .txt-Datei herunter.
Funktioniert es mit gescannten PDFs?
Ja. Seiten mit echter Textebene werden exakt gelesen, Seiten ohne werden per OCR erkannt. Beides wird im selben Dokument automatisch gehandhabt.
Kann ich nur eine Seite kopieren?
Ja. Jede Seite hat eine eigene Kopierschaltfläche, und Sie können auch das ganze Dokument kopieren oder als .txt-Datei mit erhaltener Seitennummerierung herunterladen.
Ist der extrahierte Text exakt?
Ja, bei Seiten, die bereits Text enthalten, weil der Text direkt gelesen wird. Bei gescannten Seiten wird der Text erkannt und kann Fehler enthalten.
Bleiben Tabellen und Spalten erhalten?
Nein. Der Text kommt als einfache Zeilen heraus, Seite für Seite. Tabellen verlieren ihr Raster, und auf einer mehrspaltig gesetzten Seite können Zeilen aus benachbarten Spalten ineinanderlaufen. Für Tabellen behält PDF in Excel die Zellen bei.
Was passiert mit meiner Datei?
Es bleibt auf Ihrem Gerät. Ihr Browser liest den Text und erkennt auch gescannte Seiten, daher wird das PDF nicht hochgeladen. Nur wenn Ihr Browser die Texterkennung nicht ausführen kann, werden die gescannten Seiten stattdessen als Bilder über eine verschlüsselte Verbindung an unseren Server gesendet und gelöscht, sobald sie gelesen wurden. Wir speichern, dass das Tool benutzt wurde, aber nicht den Inhalt der Datei.
Ist es kostenlos?
Ja. Jedes Tool funktioniert ohne Bezahlung und ohne Konto. Dateien dürfen bis zu 200 Seiten und 50 MB groß sein, und ein fehlgeschlagener Durchgang kostet Sie nichts. Pro hebt die Limits auf.
Muss ich ein Konto erstellen?
Nein. Alle Werkzeuge funktionieren ohne Anmeldung. Ein Konto erhöht Ihr Kontingent und zeigt Ihnen, was Sie verarbeitet haben.