PDF na tekst
Wyodrębnij cały tekst z PDF, także ze zeskanowanych stron dzięki OCR.
- Bezpłatne
- Działa na każdym urządzeniu
- Zostaje na Twoim urządzeniu
- Osadzony tekst odczytany dokładnie
- Rozpoznano zeskanowane strony
- Wszystkie strony w jednym pliku
- Skopiuj lub pobierz
Przeciągnij i upuść plik tutaj
lub wybierz plik z urządzenia
Wybierz PDF, aby wyodrębnić z niego tekst
Tylko pliki PDF
Brak internetu? Pobierz aplikację na WindowsNa telefonie? Pobierz aplikację na telefon
Język rozpoznamy na podstawie samego dokumentu.
Wszystko, co potrafi PDF na tekst
Wyciągnij tekst z każdej strony PDF-a. Tekst już zawarty w pliku jest odczytywany dokładnie, a zeskanowane strony są za Ciebie rozpoznawane.
Co odczytuje
- Osadzony tekst pobrany dokładnie tak, jak jest zapisany w pliku
- Zeskanowane strony rozpoznawane automatycznie, strona po stronie
- Dokument łączący prawdziwy tekst ze skanami, obsłużony w całości
- Zachowane podziały wierszy, dzięki czemu strona czyta się we właściwej kolejności
Język dokumentu
- Rozpoznaj język na podstawie samego dokumentu
- Bengalski, angielski, hindi, arabski, chiński, rosyjski, hiszpański, portugalski i niderlandzki
- Twoje pismo i angielski odczytywane razem, dla nazwisk, dat i kwot
- Wskaż język samodzielnie i przejdź od razu do rozpoznawania
W obszarze roboczym
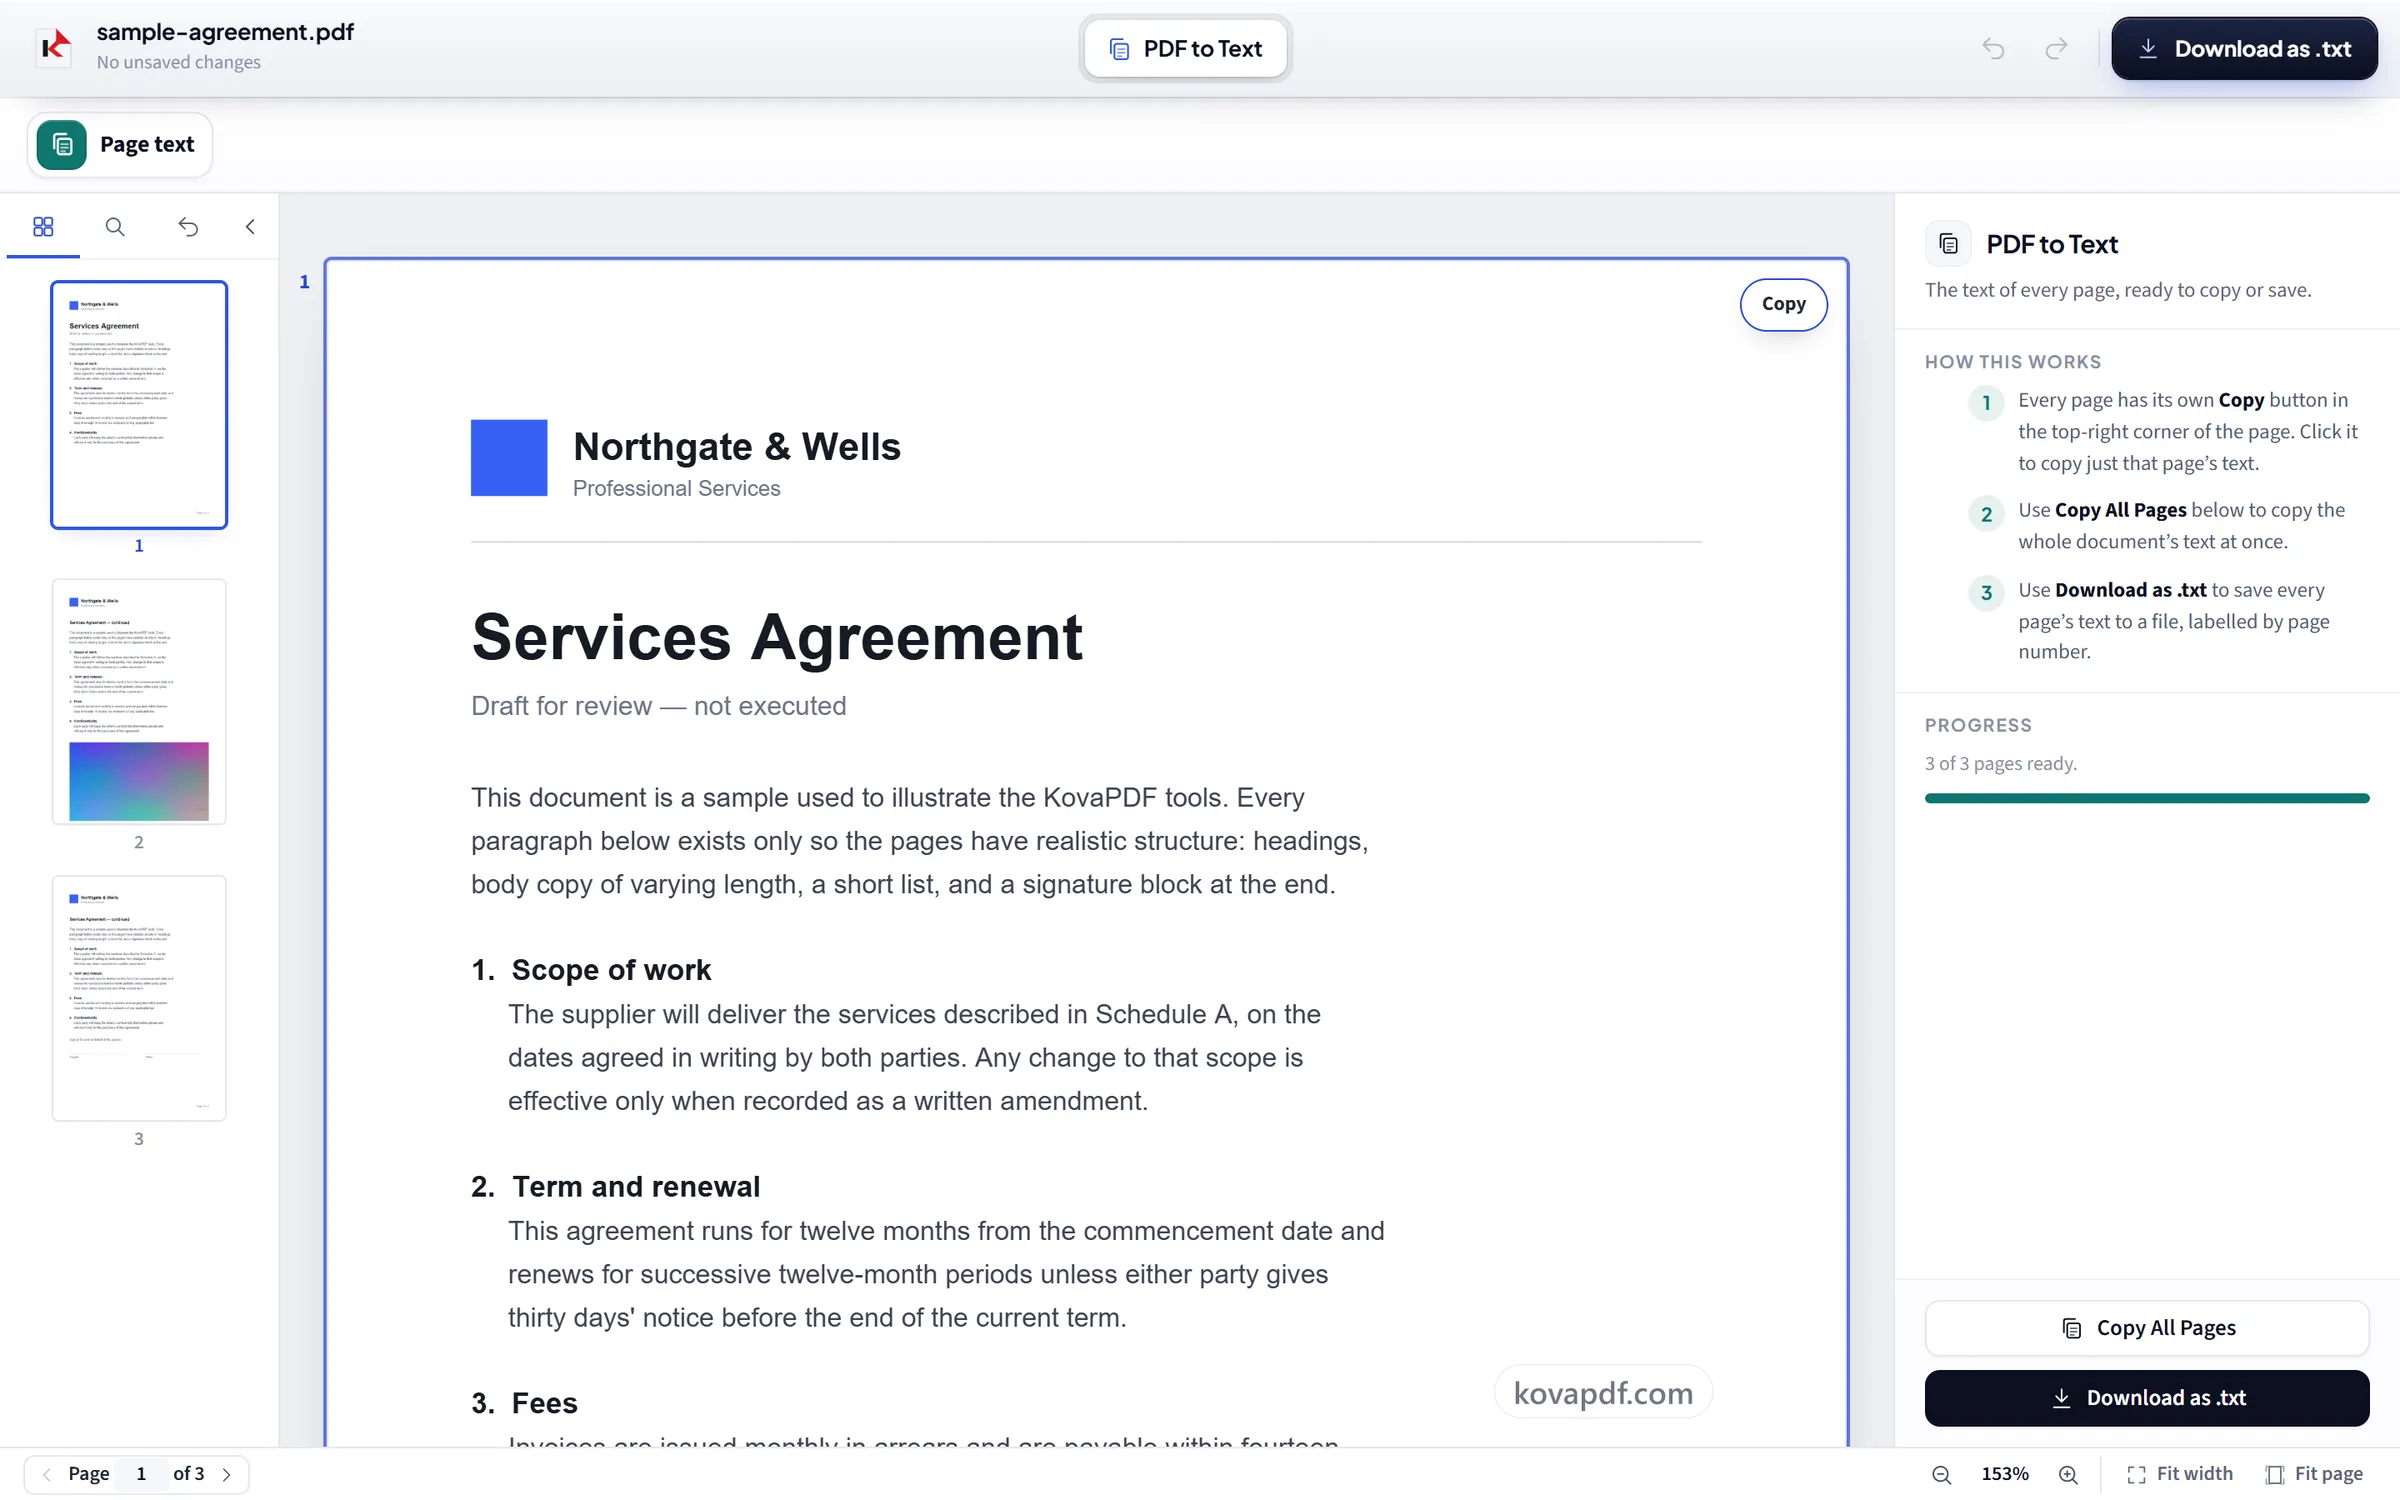
- Każda strona na ekranie z własną miniaturą
- Przejdź do dowolnej strony i czytaj jej tekst na tle strony
- Skopiuj jedną stronę przyciskiem znajdującym się na niej
- Strony otwierają się w miarę odczytywania
Zabieranie tekstu ze sobą
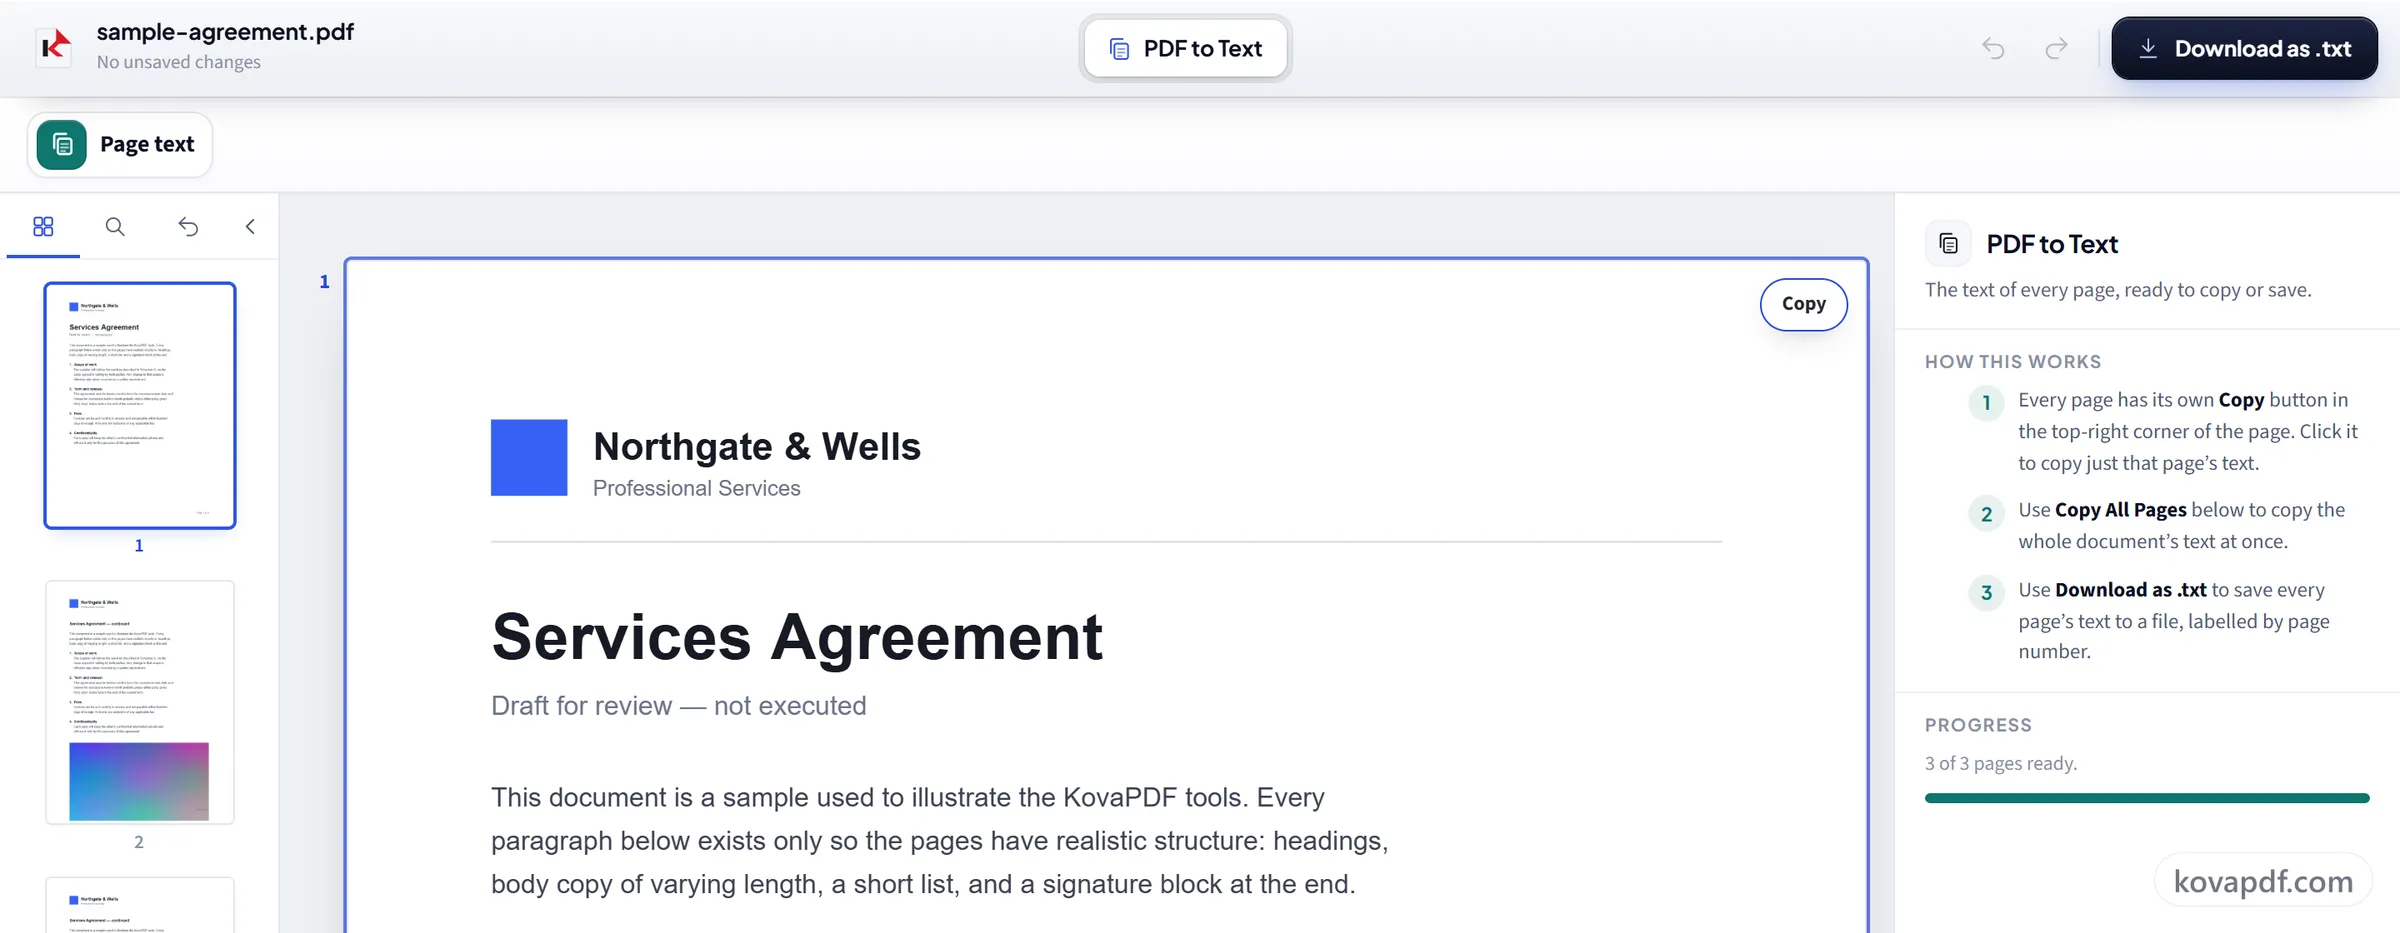
- Skopiuj wszystkie strony jednym kliknięciem
- Pobierz cały dokument jako plik .txt
- Każdy blok oznaczony numerem swojej strony
- Tekst strony, który możesz wkleić bezpośrednio do dokumentu
Jak to działa
PDF na tekst w trzech krokach
Wybierz swój PDF
Przeciągnij plik na panel albo kliknij go, aby wybrać plik z urządzenia. Strony bez warstwy tekstowej są odczytywane w twojej przeglądarce zaraz po otwarciu pliku. Tylko jeśli twoja przeglądarka nie może uruchomić rozpoznawania tekstu, te strony są wysyłane na nasz serwer jako obrazy i usuwane po odczytaniu.
Czytaj tekst strona po stronie
Każda strona ma własny przycisk Kopiuj. Skopiuj cały dokument naraz albo pobierz wszystko jako plik .txt z zachowaniem kolejności stron.
Skopiuj lub pobierz
Rozpoznany tekst to szacunek, a nie transkrypcja, więc sprawdź wszystko, na czym zamierzasz polegać, zwłaszcza liczby.
PDF na tekst: przewodnik krok po kroku w obrazach
Osadzony tekst jest odczytywany bezpośrednio. Zeskanowane strony są zamiast tego rozpoznawane, w jednym z dziewięciu języków, wykrywanym automatycznie.
Wybierz swój PDF
Przeciągnij plik na panel albo kliknij go, aby wybrać plik z urządzenia. Strony bez warstwy tekstowej są odczytywane w twojej przeglądarce zaraz po otwarciu pliku. Tylko jeśli twoja przeglądarka nie może uruchomić rozpoznawania tekstu, te strony są wysyłane na nasz serwer jako obrazy i usuwane po odczytaniu.
Czytaj tekst strona po stronie
Każda strona ma własny przycisk Kopiuj. Skopiuj cały dokument naraz albo pobierz wszystko jako plik .txt z zachowaniem kolejności stron.
Skopiuj lub pobierz
Rozpoznany tekst to szacunek, a nie transkrypcja, więc sprawdź wszystko, na czym zamierzasz polegać, zwłaszcza liczby.
Najczęstsze pytania o PDF na tekst
Jak skopiować tekst z PDF?
Otwórz tutaj PDF, a jego tekst pojawi się strona po stronie. Skopiuj jedną stronę, skopiuj cały dokument naraz albo pobierz wszystko jako plik .txt.
Czy działa ze zeskanowanymi plikami PDF?
Tak. Strony z prawdziwą warstwą tekstową są odczytywane dokładnie; strony bez niej są rozpoznawane za pomocą OCR. Oba przypadki są obsługiwane automatycznie w tym samym dokumencie.
Czy mogę skopiować tylko jedną stronę?
Tak. Każda strona ma własny przycisk kopiowania, a możesz też skopiować cały dokument lub pobrać go jako plik .txt z zachowaną numeracją stron.
Czy wyodrębniony tekst jest dokładny?
Tak, w przypadku stron, które już zawierają tekst, bo tekst jest odczytywany bezpośrednio. Na zeskanowanych stronach tekst jest rozpoznawany i może zawierać błędy.
Czy zachowa tabele i kolumny?
Nie. Tekst wychodzi jako zwykłe wiersze, strona po stronie. Tabele tracą siatkę, a na stronie złożonej w kilku kolumnach wiersze z sąsiednich kolumn mogą się zlewać. W przypadku tabel komórki zachowuje PDF do Excel.
Co się dzieje z moim plikiem?
Zostaje na twoim urządzeniu. Twoja przeglądarka odczytuje tekst i rozpoznaje też zeskanowane strony, więc PDF nie jest przesyłany. Tylko jeśli twoja przeglądarka nie może uruchomić rozpoznawania tekstu, zeskanowane strony są zamiast tego wysyłane na nasz serwer jako obrazy, szyfrowanym połączeniem, i usuwane, gdy tylko zostaną odczytane. Zapisujemy, że narzędzie zostało użyte, ale nie zawartość pliku.
Czy to jest darmowe?
Tak. Każde narzędzie działa bez płacenia i bez konta. Pliki mogą mieć do 200 stron i 50 MB, a nieudane przetwarzanie nic cię nie kosztuje. Pro znosi limity.
Czy muszę zakładać konto?
Nie. Wszystkie narzędzia działają bez logowania. Konto zwiększa Twój limit i pokazuje, co już przetworzono.
Powiązane narzędzia
Wszystkie narzędzia PDF · Jak obchodzimy się z twoimi plikami