PDF سے متن
اپنی PDF سے سیدھا متن نکالیں، شامل متن براہِ راست پڑھا جاتا ہے، اسکین شدہ صفحات OCR سے۔ ایک وقت میں ایک صفحہ کاپی کریں، سب کچھ کاپی کریں، یا سب کو متنی فائل کے طور پر ڈاؤن لوڈ کریں۔
- استعمال مفت
- کسی بھی آلے پر کام کرتا ہے
- آپ کے آلے پر ہی رہتا ہے
- شامل متن بالکل درست پڑھا جاتا ہے
- اسکین شدہ صفحات پہچانے گئے
- تمام صفحات ایک فائل میں
- کاپی کریں یا ڈاؤن لوڈ کریں
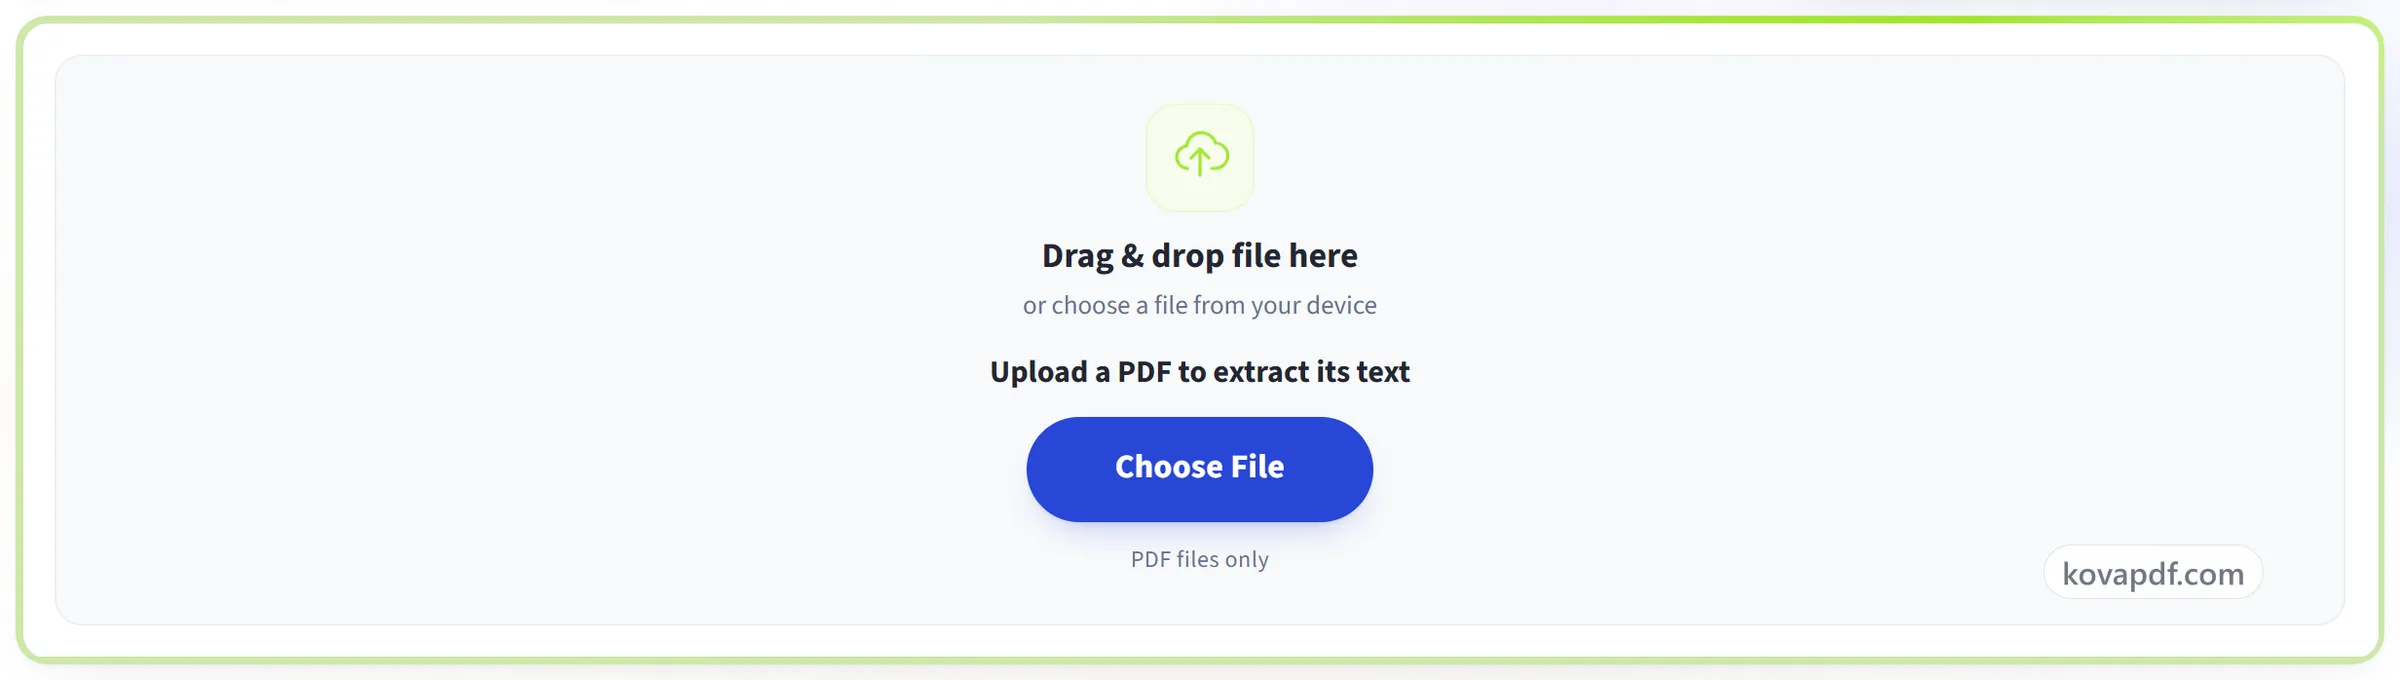
فائل یہاں گھسیٹ کر چھوڑیں
یا اپنے آلے سے فائل منتخب کریں
متن نکالنے کے لیے PDF چنیں
صرف PDF فائلیں
انٹرنیٹ نہیں ہے؟ Windows ایپ حاصل کریںفون پر؟ فون ایپ حاصل کریں
ہم زبان خود دستاویز سے پہچان لیں گے۔
PDF to Text جو کچھ کر سکتا ہے وہ سب
PDF سے ہر صفحے کا متن نکالیں۔ فائل کا موجود متن بالکل ویسا پڑھا جاتا ہے، اور اسکین شدہ صفحات آپ کے لیے پہچانے جاتے ہیں۔
یہ کیا پڑھتا ہے
- شامل شدہ متن بالکل ویسا ہی لیا گیا جیسے فائل میں محفوظ ہے
- اسکین شدہ صفحات خودکار طور پر، صفحہ بہ صفحہ پہچانے جاتے ہیں
- حقیقی متن اور اسکینز کا مرکب دستاویز مکمل طور پر سنبھالا جاتا ہے
- لائن بریکس برقرار، تاکہ صفحہ ترتیب میں پڑھا جائے
دستاویز کی زبان
- زبان خود دستاویز سے طے کریں
- بنگلا، انگریزی، ہندی، عربی، چینی، روسی، ہسپانوی، پرتگالی اور ڈچ
- آپ کا رسم الخط اور انگریزی ایک ساتھ پڑھے جاتے ہیں، ناموں، تاریخوں اور رقوم کے لیے
- زبان خود منتخب کریں اور سیدھا شناخت پر جائیں
ورک اسپیس میں
- اسکرین پر ہر صفحہ اپنے تھمب نیل کے ساتھ
- کسی بھی صفحے پر جائیں اور اس کا متن صفحے کے ساتھ ملا کر پڑھیں
- اس صفحے کے بٹن سے ایک صفحہ کاپی کریں
- ہر صفحہ پڑھے جانے کے ساتھ ساتھ کھلتا ہے
متن ہٹانا
- ایک کلک میں تمام صفحات کاپی کریں
- پوری دستاویز کو .txt فائل کے طور پر ڈاؤن لوڈ کریں
- ہر بلاک کو اس کے صفحہ نمبر کا لیبل دیا گیا
- صفحے کا متن جسے آپ براہ راست کسی دستاویز میں پیسٹ کر سکتے ہیں
یہ کیسے کام کرتا ہے
تین مراحل میں PDF سے متن
اپنی PDF چنیں
اپنی فائل پینل پر گھسیٹیں، یا اپنے آلے سے ایک فائل چننے کے لیے اس پر کلک کریں۔ جن صفحات پر کوئی متنی تہہ نہیں، وہ فائل کھلتے ہی آپ کے براؤزر میں پڑھے جاتے ہیں۔ صرف اس صورت میں کہ آپ کا براؤزر پڑھنے والا ٹول نہ چلا سکے، وہ صفحات تصاویر کی شکل میں ہمارے سرور پر بھیجے جاتے ہیں، اور پڑھ لیے جانے کے بعد حذف کر دیے جاتے ہیں۔
متن صفحہ بہ صفحہ پڑھیں
ہر صفحے کا اپنا 'کاپی' بٹن ہے۔ پوری دستاویز ایک ساتھ کاپی کریں، یا صفحات کی ترتیب کے ساتھ سب کچھ .txt فائل کے طور پر ڈاؤن لوڈ کریں۔
کاپی یا ڈاؤن لوڈ کریں
پہچانا گیا متن لفظ بہ لفظ نقل نہیں بلکہ ایک اندازہ ہے، اس لیے جس پر بھی بھروسہ کرنا ہو اسے جانچ لیں، خاص طور پر اعداد۔
PDF سے متن: تصویروں میں مرحلہ وار
شامل شدہ متن براہِ راست پڑھا جاتا ہے۔ اسکین شدہ صفحات کو خودکار طور پر پہچانی جانے والی نو زبانوں میں سے کسی میں بھی پہچانا جاتا ہے۔
اپنی PDF چنیں
اپنی فائل پینل پر گھسیٹیں، یا اپنے آلے سے ایک فائل چننے کے لیے اس پر کلک کریں۔ جن صفحات پر کوئی متنی تہہ نہیں، وہ فائل کھلتے ہی آپ کے براؤزر میں پڑھے جاتے ہیں۔ صرف اس صورت میں کہ آپ کا براؤزر پڑھنے والا ٹول نہ چلا سکے، وہ صفحات تصاویر کی شکل میں ہمارے سرور پر بھیجے جاتے ہیں، اور پڑھ لیے جانے کے بعد حذف کر دیے جاتے ہیں۔
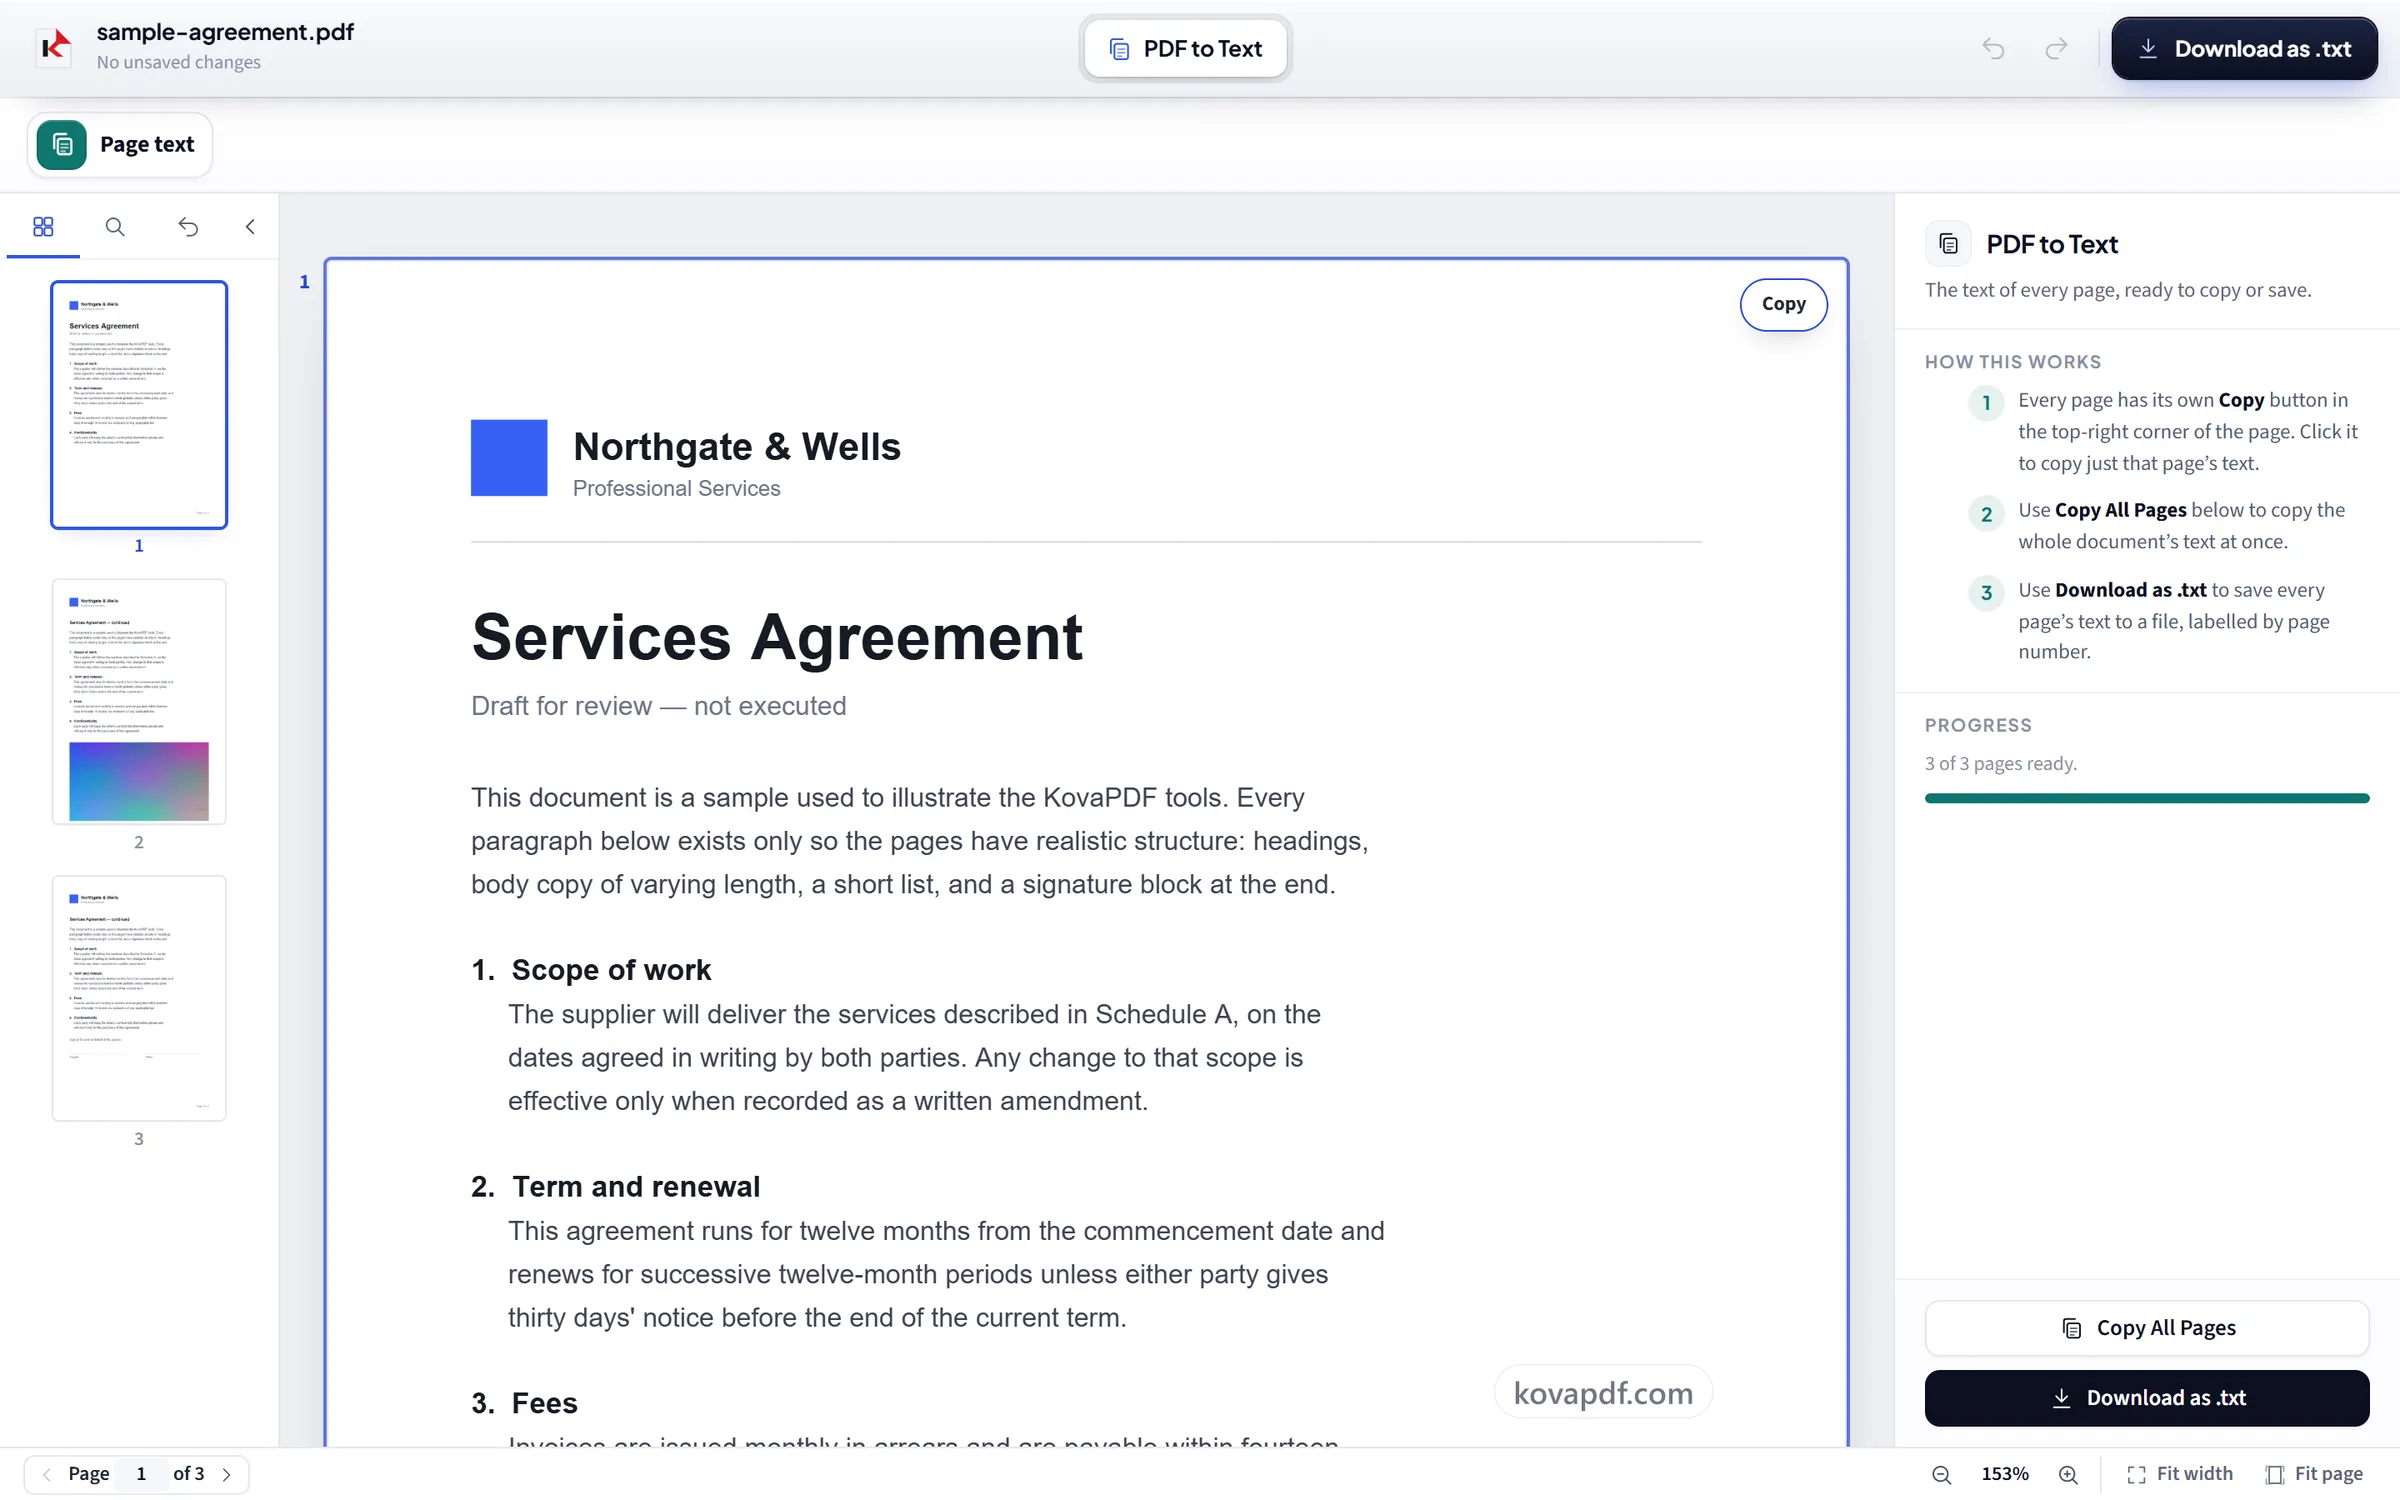
متن صفحہ بہ صفحہ پڑھیں
ہر صفحے کا اپنا 'کاپی' بٹن ہے۔ پوری دستاویز ایک ساتھ کاپی کریں، یا صفحات کی ترتیب کے ساتھ سب کچھ .txt فائل کے طور پر ڈاؤن لوڈ کریں۔
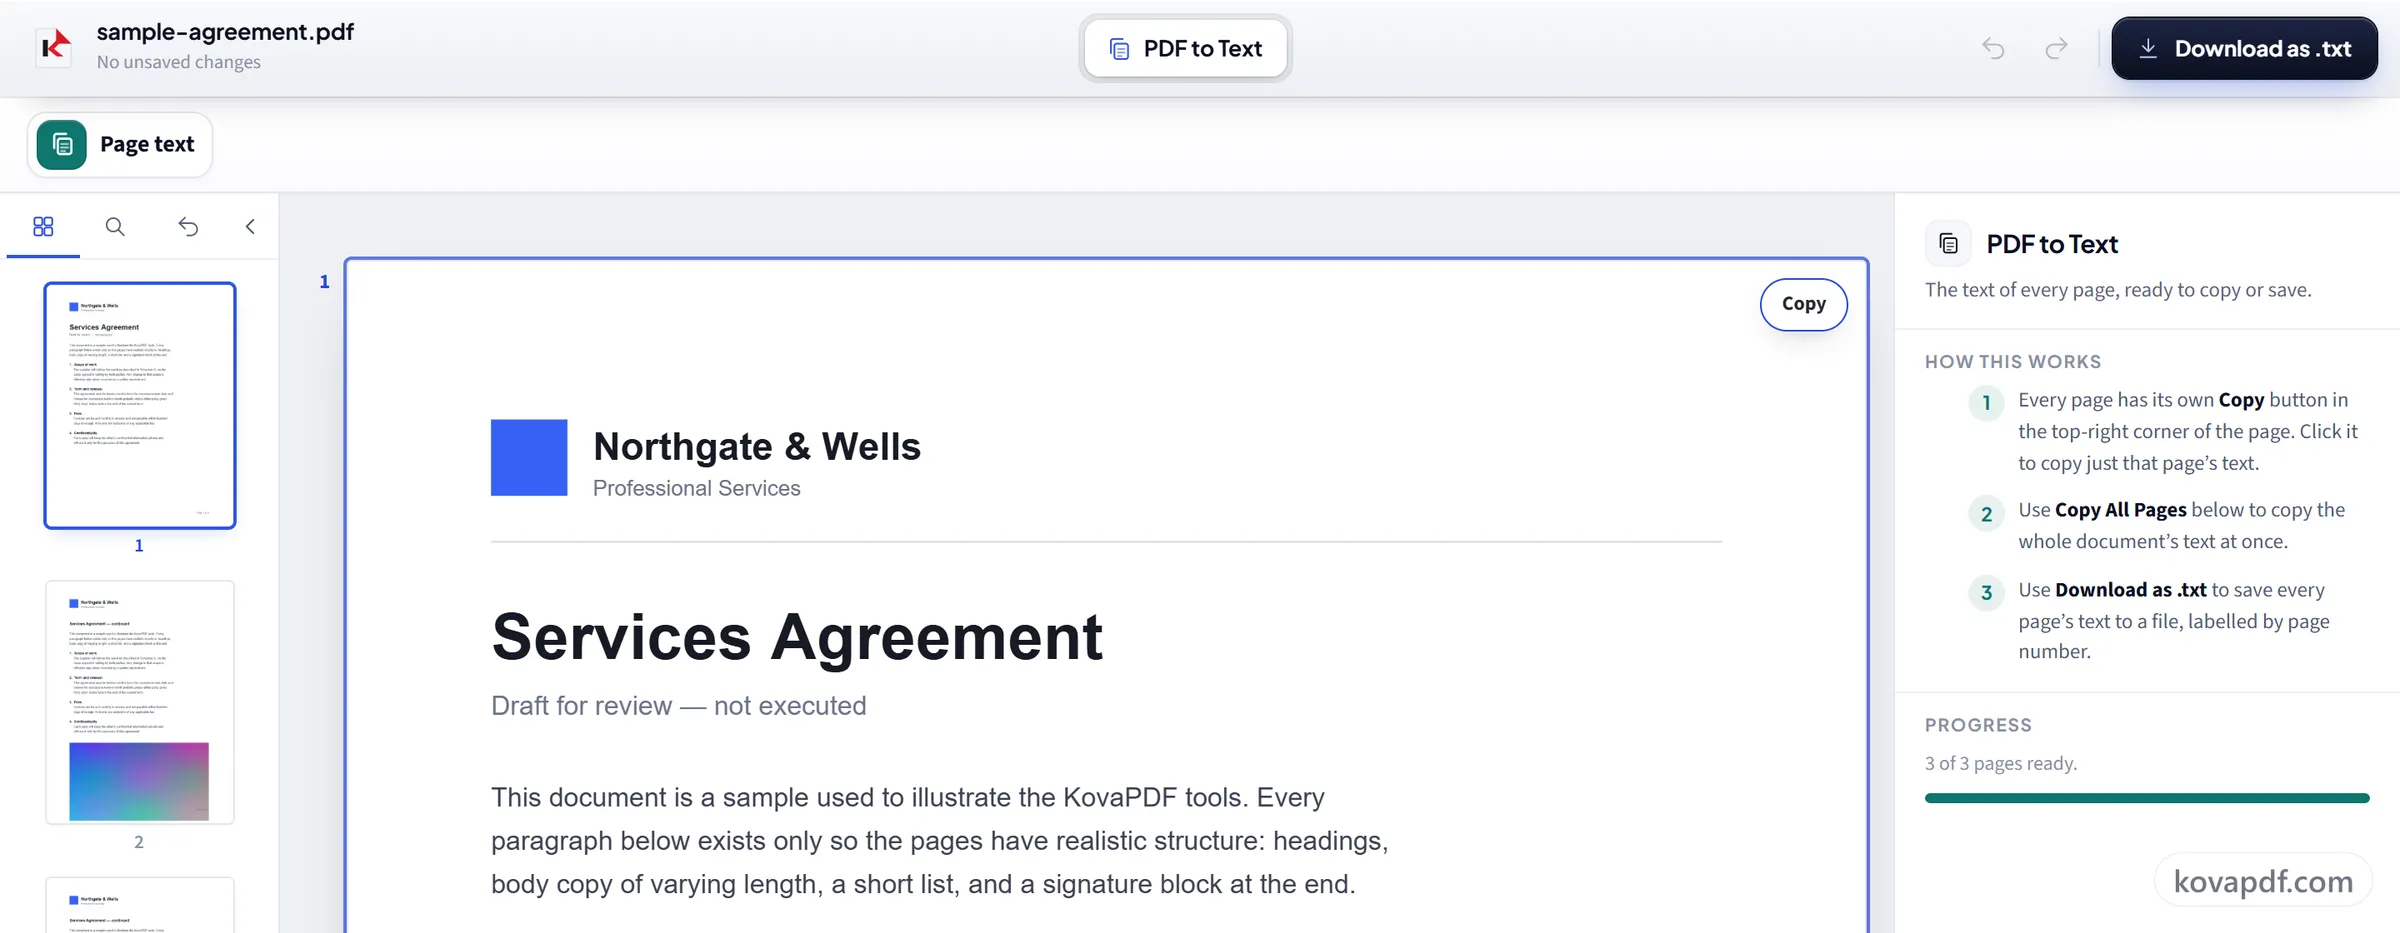
کاپی یا ڈاؤن لوڈ کریں
پہچانا گیا متن لفظ بہ لفظ نقل نہیں بلکہ ایک اندازہ ہے، اس لیے جس پر بھی بھروسہ کرنا ہو اسے جانچ لیں، خاص طور پر اعداد۔
PDF سے متن کے بارے میں عام سوالات
PDF سے متن کیسے کاپی کروں؟
PDF یہاں کھولیں اور اس کا متن صفحہ بہ صفحہ ظاہر ہو جاتا ہے۔ ایک صفحہ کاپی کریں، پوری دستاویز ایک ساتھ کاپی کریں، یا سب کچھ .txt فائل کے طور پر ڈاؤن لوڈ کریں۔
کیا یہ اسکین شدہ PDF پر کام کرتا ہے؟
ہاں۔ اصل متن کی تہہ والے صفحات بالکل درست پڑھے جاتے ہیں؛ جن میں تہہ نہیں انہیں OCR سے پہچانا جاتا ہے۔ ایک ہی دستاویز میں دونوں خود بخود سنبھالے جاتے ہیں۔
کیا میں صرف ایک صفحہ کاپی کر سکتا ہوں؟
ہاں۔ ہر صفحے کا اپنا کاپی بٹن ہے، اور آپ پوری دستاویز بھی کاپی کر سکتے ہیں یا صفحہ نمبروں کے ساتھ .txt فائل کے طور پر ڈاؤن لوڈ کر سکتے ہیں۔
کیا نکالا گیا متن بالکل درست ہے؟
جی ہاں، ان صفحات کے لیے جن میں پہلے سے متن ہے، کیونکہ متن براہ راست پڑھا جاتا ہے۔ اسکین شدہ صفحات کا متن پہچانا جاتا ہے اور اس میں غلطیاں ہو سکتی ہیں۔
کیا یہ ٹیبلز اور کالم برقرار رکھے گا؟
نہیں۔ متن صفحہ بہ صفحہ سادہ لائنوں کی صورت میں نکلتا ہے۔ ٹیبلز اپنا گرڈ کھو دیتے ہیں، اور کئی کالموں میں ترتیب دیے گئے صفحے پر ساتھ والے کالموں کی لائنیں آپس میں مل سکتی ہیں۔ ٹیبلز کے لیے “PDF سے Excel” سیلز کو برقرار رکھتا ہے۔
میری فائل کا کیا ہوتا ہے؟
یہ آپ کے آلے پر رہتی ہے۔ آپ کا براؤزر متن پڑھتا ہے، اور اسکین شدہ صفحات بھی پہچانتا ہے، اس لیے PDF اپ لوڈ نہیں ہوتی۔ صرف اس صورت میں کہ آپ کا براؤزر پڑھنے والا ٹول نہ چلا سکے، اسکین شدہ صفحات اس کے بجائے تصاویر کی شکل میں، ایک انکرپٹڈ کنکشن پر ہمارے سرور پر بھیجے جاتے ہیں، اور پڑھ لیے جانے کے فوراً بعد حذف کر دیے جاتے ہیں۔ ہم یہ ریکارڈ رکھتے ہیں کہ ٹول استعمال ہوا، لیکن فائل کا مواد نہیں۔
کیا یہ مفت ہے؟
ہاں۔ ہر ٹول بغیر ادائیگی اور بغیر اکاؤنٹ کے کام کرتا ہے۔ فائلیں 200 صفحات اور 50 MB تک ہو سکتی ہیں، اور ناکام کام کی آپ کو کوئی قیمت نہیں دینی پڑتی۔ Pro حدیں ختم کر دیتا ہے۔
کیا مجھے اکاؤنٹ بنانا ہوگا؟
نہیں۔ تمام ٹولز سائن ان کے بغیر کام کرتے ہیں۔ اکاؤنٹ آپ کی حد بڑھاتا ہے اور دکھاتا ہے کہ آپ نے کیا کچھ پروسیس کیا ہے۔